Infraestructura · Continuidad
Casi pérdida total: un ransomware, un Proxmox sin actualizar y la importancia de llegar a tiempo
Hay experiencias que cambian la manera en que uno entiende su trabajo. Después de años desarrollando software, administrando servidores y resolviendo incidentes, todavía aparecen situaciones que obligan a detenerse, ordenar las ideas y poner a prueba todo lo aprendido.
A finales de agosto de 2026 nos tocó enfrentar una de ellas: un incidente de ransomware que afectó la infraestructura de un cliente.
El problema era especialmente difícil porque no había respaldos recientes ni una infraestructura alternativa preparada para continuar operando. Había que evaluar los daños, preservar lo que quedaba y construir una salida mientras los servicios estaban interrumpidos.
Desde fuera, alguien podía resumirlo como "el servidor se cayó". Desde dentro, estábamos frente a una operación que necesitaba volver a funcionar y una recuperación cuyo resultado todavía no podíamos conocer.
00 / SEÑALESLas primeras señales
Todo empezó con algo simple: los servicios dejaron de responder. Era la mañana del domingo 30 de agosto de 2026. El aviso llegó como suelen llegar estas cosas: el sistema simplemente no estaba disponible para quienes lo necesitaban.
Al principio parecía una falla más. Pero al entrar al host Proxmox, el panorama era otro: todas las máquinas virtuales estaban detenidas, y el volumen donde vivían sus discos (/var/lib/vz, unos 3,6 TB sobre un RAID1) ya no estaba montado. Alguien había comentado su línea en /etc/fstab y la había marcado como workx-encrypted.
Lo curioso es que el hardware estaba sano: el RAID figuraba limpio y los discos pasaban SMART sin sectores dañados. El problema no era físico. El sistema de archivos tenía dañados el superbloque principal, el journal, los bitmaps y los descriptores de grupo; los superbloques de respaldo todavía lo identificaban como EXT4, pero el árbol de directorios ya no era accesible desde el original.
En /root, /tmp y /opt había una nota llamada README_DESTROY.txt, junto con archivos WORK_SELF_PUBLIC.pem y WORK_SELF_KEY_ID.txt. La línea de tiempo de esos archivos situaba la acción entre las 7:43 y las 7:48 de esa misma mañana.
Ese fue el momento en que el diagnóstico cambió: no estábamos frente a una falla, sino frente a un incidente de seguridad. Y cambiar el diagnóstico cambia también la forma de actuar. Ya no se trataba de "levantar lo que se cayó", sino de entender qué estaba comprometido antes de tocar nada más.
Al revisar más a fondo apareció algo más: además del cifrado, habían dejado un minero de Monero (XMRig) disfrazado de servicio de Proxmox («node health monitor»), con persistencia en systemd, una librería LD_PRELOAD para ocultar procesos y scripts que borraban el historial de la consola. No encontramos una familia de ransomware conocida; los indicadores coincidían con reportes públicos recientes de intrusiones contra servidores Proxmox expuestos. El ejecutable que cifró no quedó visible: todo indica que se borró después de actuar.
El servidor tenía servicios expuestos a Internet que no debían estarlo —rpcbind con cientos de conexiones externas y el panel de Proxmox abierto— y el firewall de Proxmox estaba en estado fallido. La causa, en el fondo, fue sencilla: el atacante aprovechó una vulnerabilidad reciente de Proxmox, y el servidor no estaba actualizado. Un hipervisor sin parches y con su administración expuesta a Internet es una puerta abierta, y alguien la encontró antes que nosotros.
01 / HALLAZGOSQué encontramos
La infraestructura utilizaba Proxmox y máquinas virtuales. El daño alcanzaba el almacenamiento que las sostenía, por lo que el trabajo iba más allá de reinstalar una aplicación o levantar nuevamente una base de datos.
En ese volumen estaban los discos de más de diez máquinas virtuales —desde algunas de 32 GB hasta una de 1,2 TB— y también los respaldos locales. Entre ellas, la base de datos operativa del cliente y servidores de aplicación y comunicaciones. De esas máquinas dependía el día a día del cliente: su información operativa y los servicios con los que atendía a sus propios usuarios.
Lo más delicado no era solo lo afectado, sino lo que faltaba. Este cliente no contaba con respaldos ni contingencia fuera de su servidor: los respaldos estaban en el mismo volumen que fue atacado, así que corrieron la misma suerte. No había un respaldo independiente al cual volver ni un entorno alternativo donde mover la operación. Eso definió todo lo que vino después.
02 / PRESERVARPrimero, conservar la posibilidad de recuperar
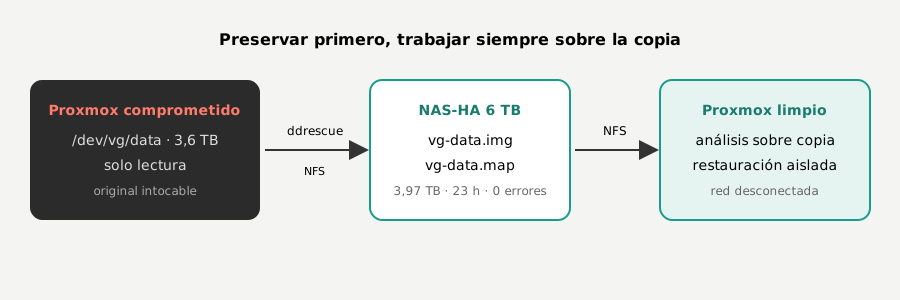
Una de las decisiones más importantes fue preservar la información disponible antes de avanzar con las pruebas de recuperación.
Las primeras horas fueron de solo lectura: inventario, discos, RAID, estado del sistema de archivos, procesos y accesos. Ningún intento de reparación sobre el original. Al mismo tiempo cerramos exposición desde el firewall del proveedor, empezando por los puertos que no tenían por qué estar abiertos, con cuidado de no cortar nuestro propio acceso. No limpiamos el servidor todavía: mientras la copia no estuviera completa, cualquier cambio en el host podía costarnos evidencia o datos.
Creamos una imagen del volumen afectado con ddrescue, una herramienta que permite copiar medios de almacenamiento y registrar el avance del rescate en un archivo de mapa. Eso significa que la copia puede interrumpirse y retomarse, y que sabemos con precisión qué zonas se leyeron bien y cuáles no. Esa copia nos daba una base sobre la cual analizar y trabajar, sin seguir exponiendo el original a cada intento.
La copia empezó esa misma mañana, a las 9:56, y terminó al día siguiente: 3,97 TB copiados en 23 horas y 4 minutos, al 100 %, sin errores de lectura ni sectores dañados. Desde ese momento, el original quedó como origen intocable y todo el trabajo se hizo sobre la imagen.
Para mí, esa parte resume muy bien lo que significa resolver una emergencia con criterio: cada intento debe cuidar las posibilidades del siguiente.
La presión invita a ejecutar algo inmediatamente. La experiencia ayuda a reconocer cuándo una acción puede acercarnos a una solución y cuándo puede cerrar una puerta que todavía necesitamos abierta.
03 / DOS FRENTESRecuperar información y restablecer servicios eran trabajos distintos
Durante el incidente tuvimos que atender dos necesidades al mismo tiempo.
Por un lado, investigar qué información podía rescatarse del entorno afectado. Por otro, preparar infraestructura para que los servicios comenzaran a funcionar nuevamente.
Contratamos un NAS-HA de 6 TB en OVH, montado por NFS con acceso restringido por IP, para alojar la imagen y su mapa sin depender del servidor comprometido. Y desplegamos un nuevo servidor Proxmox, limpio, que también accedía al NAS para analizar y restaurar. El trabajo incluyó reconstruir infraestructura, volver a configurar servicios y avanzar con el restablecimiento mientras continuaba el análisis de los datos.
Esa separación fue fundamental para salir adelante. La recuperación del almacenamiento tenía incertidumbres y tiempos propios; la continuidad de la operación exigía decisiones que podíamos comenzar a ejecutar.
Aprendimos a medir el avance con precisión. Un servicio disponible representaba un paso concreto. Un dato recuperado representaba otro. Había que validar ambos y comunicar su alcance.
04 / PROCESOEl proceso, paso a paso
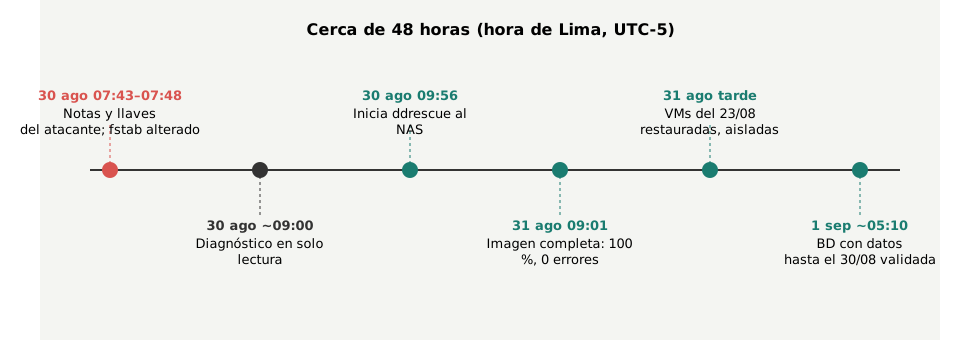
Visto en orden, el camino de salida fue más o menos así:
- Confirmar que era un ransomware y contener. Inventario en solo lectura, identificación de los artefactos y cierre de puertos expuestos desde el firewall del proveedor.
- Preservar antes de intervenir. Imagen completa del volumen con ddrescue, trabajando siempre sobre copias.
- Conseguir espacio para trabajar. El NAS nos dio capacidad para alojar la imagen y los datos rescatados sin depender del hardware comprometido.
- Construir un entorno limpio. Un Proxmox nuevo, instalado desde cero, en lugar de "limpiar" el anterior.
- Reconstruir el sistema de archivos en una capa aparte. La reparación se hizo sobre una capa copy-on-write encima de la imagen, nunca sobre la imagen maestra. Así aparecieron nombres, discos de VM y respaldos dentro de
lost+found. - Validar antes de confiar. Los discos QCOW2 encontrados estaban muy dañados: cinco de seis con corrupción fuerte y uno sin cabecera válida. Los respaldos más recientes, los del mismo 30 de agosto, también estaban corruptos. Probamos uno por uno los respaldos anteriores: los del 23 de agosto de dos VMs críticas —entre ellas la base de datos— pasaron las pruebas de integridad completas.
- Restaurar primero lo crítico, aislado. Esas dos VMs se restauraron en el servidor nuevo apagadas, con la red desconectada, y solo se encendieron después de revisarlas.
- Recuperar la semana que faltaba. La base de datos del 23 estaba sana, pero el negocio necesitaba la información hasta el 30. Buscamos en la imagen páginas de InnoDB posteriores al 23, las validamos y reconstruimos registros fuera de la base sana, con trazabilidad de su origen. Así recuperamos datos hasta la madrugada del 30 de agosto: en total, 468.521 filas consolidadas. Después validamos todas las relaciones (444 claves foráneas sin huérfanos) y las 1.074 tablas.
- Reconfigurar y validar cada servicio. Volver a configurar, probar y confirmar que funcionaba, no solo que "arrancaba". Los servicios fueron volviendo según su criticidad, empezando por la base de datos de la que dependía la operación.
- Comunicar el alcance con honestidad. Informar al cliente qué estaba de vuelta, qué seguía en análisis y qué probablemente no volvería.
Desde el primer diagnóstico, el domingo 30 por la mañana, hasta cerrar la recuperación de la base de datos con un respaldo verificado en el NAS, pasaron cerca de 48 horas: terminamos la madrugada del 1 de septiembre. Hubo partes que no volvieron completas: algunas VMs solo tenían respaldos antiguos o discos dañados, y para ellas quedó una recuperación parcial, por archivos. Lo digo sin rodeos: con ransomware, casi siempre el final es la pérdida total. En este caso estuvimos muy cerca, y lo que lo evitó fue la forma de responder.
05 / LA IMAGENLa anécdota estaba detrás de una imagen de disco
De aquella experiencia me quedó especialmente presente una imagen de recuperación: un archivo enorme que contenía lo que habíamos podido copiar del volumen afectado.
Técnicamente, era una imagen de disco de casi 4 TB. En términos humanos, representaba información de trabajo, registros y la posibilidad de reconstruir parte de lo que se había perdido.
Quienes trabajamos con infraestructura estamos acostumbrados a hablar de volúmenes, particiones, sistemas de archivos y máquinas virtuales. Durante una crisis se vuelve evidente lo que existe detrás de esas palabras: personas esperando continuar con sus tareas y una empresa intentando recuperar su ritmo.
Desde entonces, cuando pienso en un respaldo, también pienso en el tiempo que puede devolverle a una organización.
06 / SALIDACómo logramos salir adelante
Lo que nos permitió avanzar fue combinar conocimientos que normalmente se utilizan por separado: Linux, virtualización, almacenamiento, bases de datos, aplicaciones y redes.
Comprender cómo se conectaban esas piezas ayudó a reconstruir el entorno y a decidir dónde concentrar el esfuerzo. También nos obligó a investigar, revisar resultados y ajustar el camino cuando una alternativa no ofrecía avances. Un ejemplo: los discos virtuales que encontramos parecían la ruta más directa, pero estaban demasiado dañados para arrancarlos. Los respaldos más recientes tampoco servían. Tuvimos que retroceder hasta los respaldos del 23 de agosto y, desde ahí, ir a buscar la semana faltante directamente en las páginas de la base de datos.
Hubo recuperación parcial y trabajo de reconstrucción. También hubo incertidumbre. Contarlo con honestidad forma parte del aprendizaje.
Restablecer servicios fue un logro concreto; conocer los límites de la recuperación fue una responsabilidad igual de importante.
Esa es la parte de nuestra respuesta que más valoro: pudimos convertir un escenario crítico en tareas ejecutables, sostener el trabajo y construir una vía para retomar la operación.
07 / EL CLIENTELo que cambió en la manera del cliente de mirar los respaldos
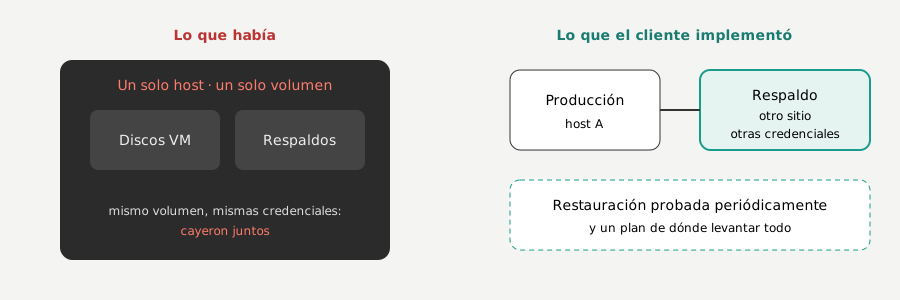
Antes del incidente, varias recomendaciones ya estaban sobre la mesa: respaldos fuera del servidor, redundancia, un plan de contingencia y pruebas periódicas de restauración. No se priorizaron. Mientras todo funcionaba, parecían gastos que podían esperar.
El incidente cambió esa conversación. Lo que antes se veía como un costo, el cliente pasó a verlo como lo que realmente es: la condición para seguir operando. Y esta vez no hizo falta insistir; fue el propio cliente quien pidió implementarlas.
Hoy las preguntas sobre continuidad ya no las planteo solo yo; son las que el cliente quiere tener respondidas:
- ¿Qué antigüedad tiene la información que realmente podemos restaurar?
- ¿Cuándo se probó por última vez esa restauración?
- ¿Dónde funcionarían los servicios si el servidor principal quedara inutilizable?
- ¿Qué debemos levantar primero para que la empresa pueda trabajar?
- ¿Quién conoce las dependencias y tiene los accesos necesarios?
También entendió una diferencia que antes no era evidente: no es lo mismo protegerse frente a una falla de disco que prepararse para perder un entorno completo. Su RAID estaba sano y aun así casi lo perdió todo. La redundancia del almacenamiento cumple una función; los respaldos independientes —fuera del mismo host y fuera del alcance de las mismas credenciales— y la capacidad de reconstrucción cumplen otras.
Para mí, como proveedor, queda una lección más simple: una recomendación no basta con darla; hay que explicar qué costaría no tomarla.
08 / REDUNDANCIAEl costo de economizar la redundancia
Lo veo seguido: muchos clientes prefieren economizar y evitan gastar en redundancia. Un segundo servidor, respaldos fuera del sitio, monitoreo… parecen gastos que no producen nada mientras todo funciona. Y, por experiencia lo digo, muchos se la juegan.
La redundancia es como un seguro: nunca sabes cuándo lo vas a usar, pero es mejor tenerlo que enfrentar lo peor sin él.
Esta vez se pudo recuperar. No siempre ha sido así. En otras ocasiones me llamaron tarde, cuando ya no quedaba nada que rescatar, y lo único que podía hacer era reinstalar los Windows Server y levantar la infraestructura desde cero. Esta fue la primera vez que me tocó resolver una incidencia de este tipo en servidores Linux, con un hipervisor de por medio y una imagen de casi 4 TB como única esperanza.
La diferencia entre una historia y la otra no fue la suerte: fue llegar a tiempo, no tocar lo que no se debía tocar y tener un método.
09 / DESPUÉSDespués del incidente
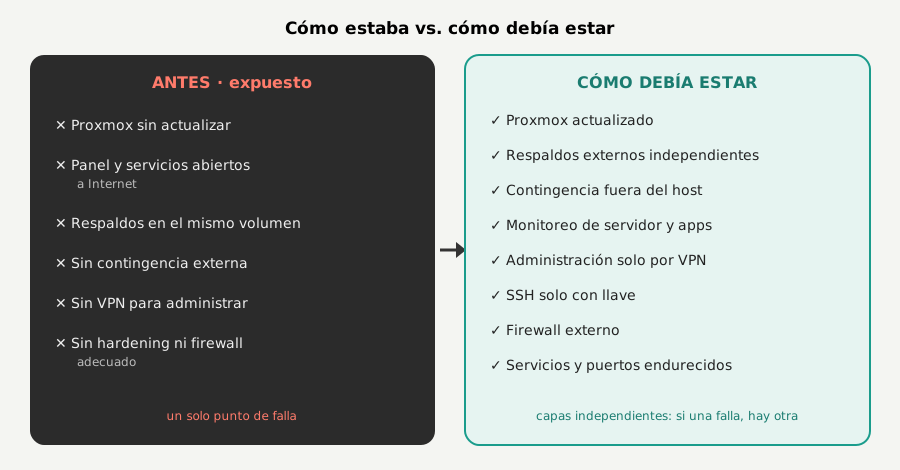
Una vez que la operación volvió, quedaba la conversación más importante: qué hacer para que no vuelva a pasar, o para que, si pasa, no sea una emergencia.
El cliente tomó varias decisiones:
- Respaldos externos. Le implementamos un servidor de respaldos fuera de su infraestructura, para que una copia nunca más dependa del mismo equipo que se quiere proteger.
- Monitoreo y respaldos gestionados. Incorporamos su entorno a nuestro centro de monitoreo y respaldos, tanto por aplicación como por servidor.
- Proxmox actualizado. Instalamos la versión actual de Proxmox, cerrando la brecha que permitió el ataque.
- Hardening. Desactivamos servicios innecesarios y bloqueamos los puertos que estaban expuestos a Internet.
- Gestión por VPN. La administración ahora se hace a través de una VPN, no desde Internet abierto.
- SSH solo con llave. Nada de acceso por contraseña.
- Firewall externo. Una capa de filtrado antes de que el tráfico llegue siquiera al servidor.
Confieso que al cliente le entró un poco de paranoia, y lo entiendo: después de ver tu operación detenida y casi perdida, cualquiera la tendría. Pero bueno, se hace lo que se puede hacer, y también lo que el cliente desea. Y en este caso, lo que desea es exactamente lo que debió estar desde el principio. :)
10 / CRITERIOUna experiencia que se convirtió en criterio
Me habría gustado aprender estas lecciones en un simulacro. Nos tocó hacerlo frente a un problema real, con decisiones difíciles y servicios que necesitaban volver a estar disponibles.
Salimos adelante preservando información, desplegando nueva infraestructura y restableciendo servicios mientras continuábamos con la recuperación. El proceso dejó aprendizajes que hoy llevo a la forma de diseñar, administrar y evaluar una plataforma.
Porque desarrollar una solución también implica pensar cómo recuperarla.
Hoy, cuando reviso un sistema, además de preguntarme si funciona, me pregunto qué necesitaríamos para volver a levantarlo si mañana dejara de existir el servidor donde está instalado.
Esa respuesta también forma parte del valor de la tecnología que entregamos.