Proyectos · IA aplicada
Menos llamadas a la IA. Más memoria propia.
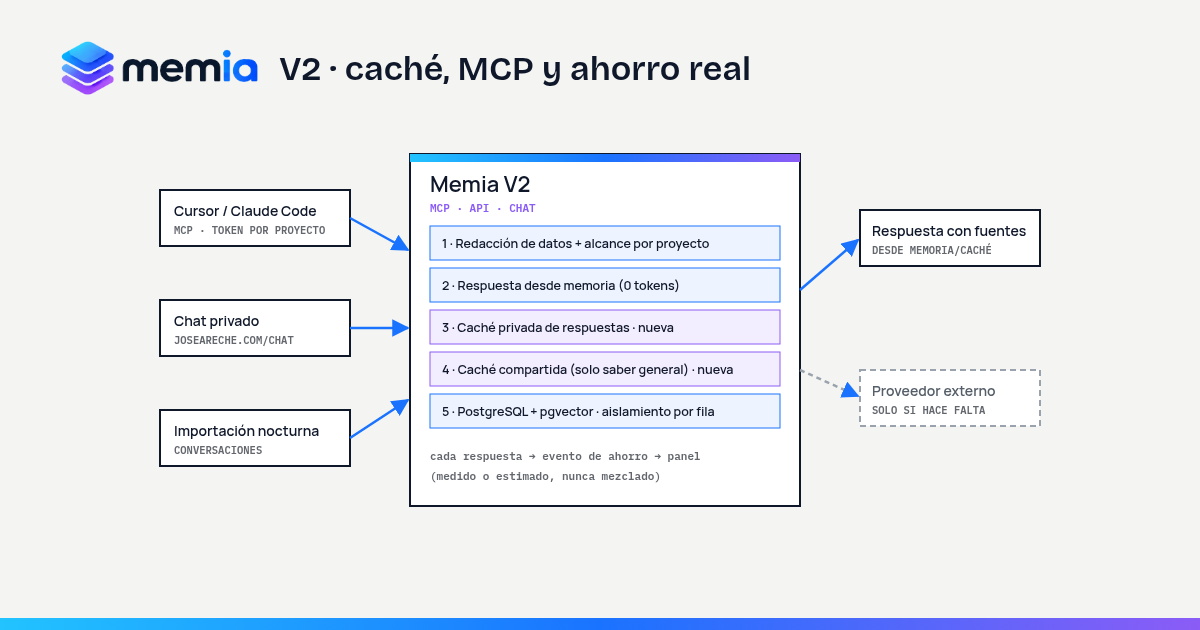
Nuevo: Memia V2 ya está en marcha, con caché de respuestas, MCP para agentes de programación y un panel de ahorro honesto. Lee qué cambió →
Cuando una organización empieza a usar IA en serio —agentes que programan, asistentes internos, operaciones de soporte— aparece un patrón: las mismas preguntas, los mismos contextos y las mismas soluciones se vuelven a enviar a un modelo externo una y otra vez. Cada repetición cuesta tokens, tiempo y, a veces, exposición de datos. Memia nace para cortar ese ciclo.
01 / EL PROBLEMALa IA olvida; la factura no
- Conocimiento disperso: soluciones valiosas quedan enterradas en conversaciones con agentes y chats que nadie vuelve a leer.
- Costo repetido: cada vez que se pregunta algo ya resuelto, se paga otra vez por procesarlo.
- Riesgo de datos: claves, tokens, correos o teléfonos pueden terminar dentro de un prompt enviado a un proveedor externo.
02 / EL ENFOQUEPrimero la memoria, después la IA
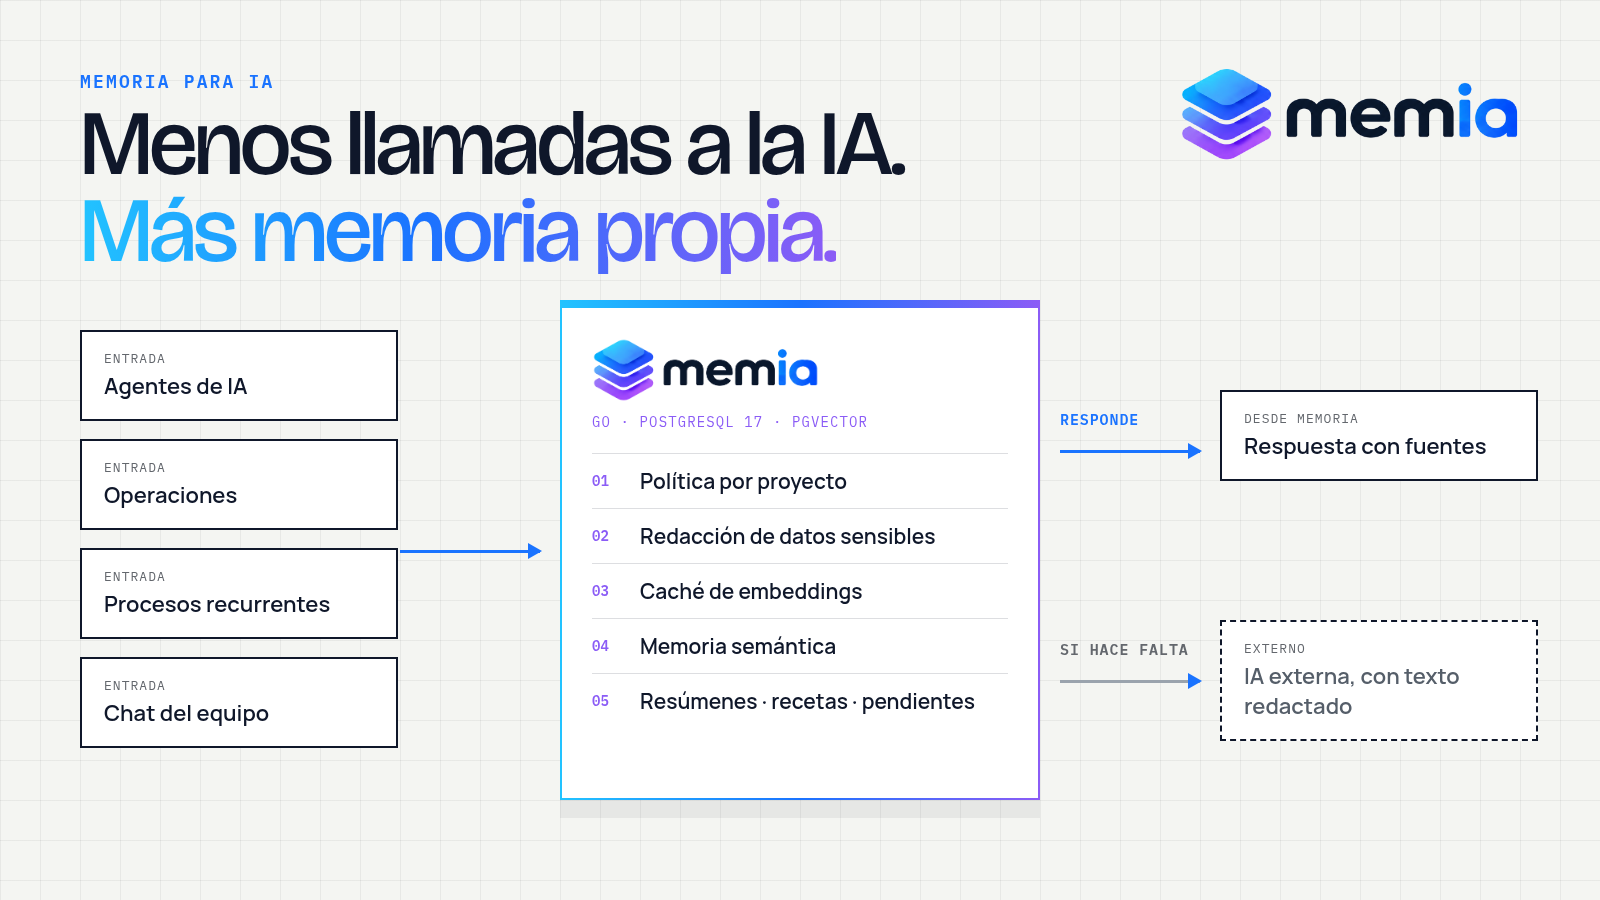
Memia es una capa de memoria que se ubica entre las personas, los agentes y los proveedores de IA. Antes de llamar a un modelo externo intenta responder con lo que la organización ya sabe, y cuando sí necesita salir, lo hace con el texto limpio de datos sensibles. Cada respuesta indica si vino de memoria o de IA externa, con sus fuentes.
03 / CÓMO FUNCIONACinco piezas
Toda llamada externa sigue el mismo orden: política del proyecto → redacción → caché → proveedor.
- Política por proyecto: cada espacio puede marcarse como «solo local»; en ese caso ningún texto sale hacia proveedores externos y, ante una política desconocida, el sistema falla cerrado.
- Redacción de datos sensibles: antes de enviar cualquier texto se eliminan claves privadas, JWT, claves API, tokens, credenciales SIP, URLs con credenciales, asignaciones tipo
password=…, correos y teléfonos. La base guarda el original; solo lo que sale se redacta. - Caché de embeddings: cada fragmento se identifica por su huella (SHA-256 del texto ya redactado, más proveedor, modelo y dimensiones). Si ya fue procesado, no se vuelve a pagar. La caché está aislada por cliente.
- Memoria semántica: PostgreSQL 17 con pgvector e índices HNSW para búsqueda por significado, combinada con búsqueda de texto completo. Los embeddings se generan con
text-embedding-3-small(1536 dimensiones). - Conocimiento destilado: resúmenes de conocimiento por proyecto, recetas extraídas de secuencias pedido → corrección → solución final (que solo pasan a «verificadas» con evidencia y aprobación humana) y pendientes detectados en las conversaciones.
Todo es multi-cliente desde la base de datos: seguridad a nivel de fila (RLS) por cliente en todas las tablas, tokens con permisos acotados y auditoría sin contenido. Los agentes acceden mediante un servidor MCP; las personas, mediante un chat privado; y la operación se sigue desde un panel administrativo con costo, aciertos de caché, errores y redacciones.
04 / RESULTADOS MEDIDOSLo que muestra el panel
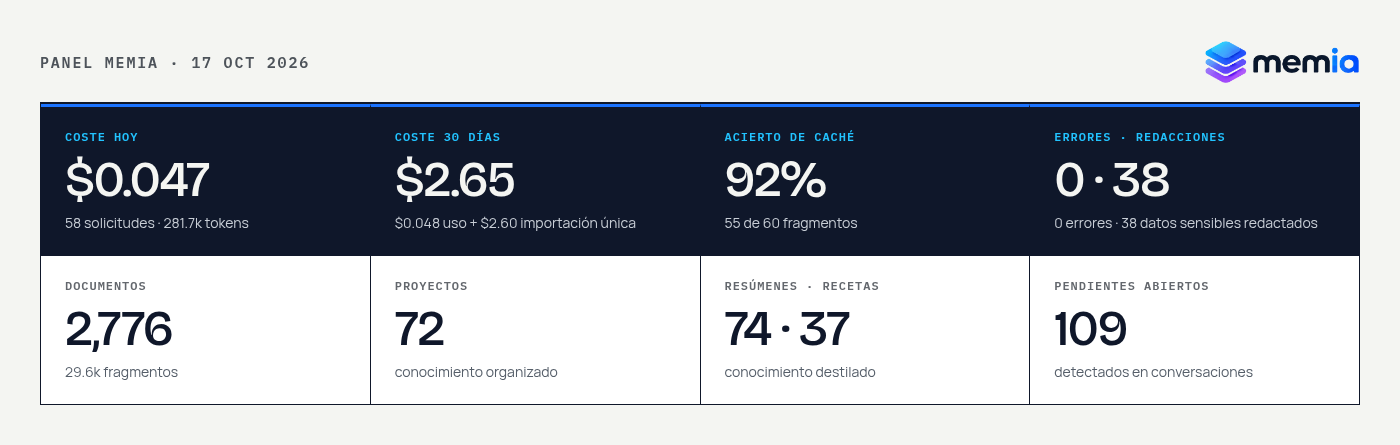
- Costo de hoy: $0.047 para 58 solicitudes y 281.7k tokens, con 0 errores.
- Costo de 30 días: $2.65, de los cuales $2.60 corresponden a la importación inicial (un costo único) y solo $0.048 al uso.
- Acierto de caché: 92 % (55 de 60 fragmentos) que no se volvieron a pagar.
- Base de conocimiento: 2,776 documentos, 29.6k fragmentos y 72 proyectos; 74 resúmenes de conocimiento, 37 recetas y 109 pendientes abiertos.
- Privacidad: 38 datos sensibles redactados antes de salir hacia un proveedor externo.
La lectura es clara: el costo grande es la carga inicial; una vez que el conocimiento está en memoria, el uso diario cuesta centavos.
05 / CASOS DE USOEmpresas e instituciones
- Equipos de desarrollo con agentes de IA: el agente consulta soluciones previas, reglas del proyecto y recetas antes de volver a razonar desde cero.
- Soporte y operaciones: incidentes recurrentes, procedimientos y configuraciones que se responden desde la memoria, con fuentes.
- Procesos internos repetitivos: preguntas frecuentes del personal sin pagar una llamada nueva por cada repetición.
- Instituciones con datos sensibles: proyectos marcados como «solo local» y redacción automática para lo que sí sale.
- Seguimiento: pendientes detectados automáticamente para que nada quede olvidado en una conversación.
06 / CÓDIGO ABIERTOMemia ya es público
El código de Memia está publicado en GitHub como código abierto, con licencia Apache 2.0. Incluye un manual de instalación en español, ejemplos de uso, documentación y un docker-compose para levantar todo con un solo comando.
07 / PLANESÚsalo gratis o te lo alojamos
Free / Community
Gratis · autoalojado
- Código abierto (Apache 2.0)
- Lo instalas en tu propio servidor
- Instalación con
docker-compose - Manual, ejemplos y documentación
Pro
Beta · por invitación · alojado por nosotros
- Ya disponible en joseareche.com/chat
- Sin servidores que mantener
- Panel de ahorro: consultas, tokens y dólares
- Backups gestionados
- Conexión MCP para Cursor
- Soporte
La versión alojada ya funciona en joseareche.com/chat (inicio con Google; acceso por invitación o registro).
¿Empresa? También ofrecemos instalación y soporte en tu propia infraestructura. Escríbenos.
08 / PRÓXIMOS PASOSLo que sigue
- Mejorar la calidad de las recetas con una pasada de IA más aprobación humana.
- Importar nuevas fuentes de conversaciones y organizar mejor las que aún no tienen proyecto.
- Incorporar un modelo local para responder sin salir de la infraestructura.
- Búsqueda híbrida, límites de costo por cliente y políticas de retención.
Si tu organización repite preguntas a la IA todos los días, probablemente ya está pagando por conocimiento que tiene.
Conversemos sobre tu caso ↗